你敢信吗?一个网页版对话框,没接API,没切模型,没抄提示词模板,就靠DeepSeek官网首页那个「输入框」,硬生生干翻了全球5746支AI战队——包括MIT、斯坦福、清华、Meta研究院的高手,还有常年混迹Kaggle Top 1%的老炮儿。冠军团队「日之光面」的两位成员,一个是Kaggle全球第一的「无敌叉烧包」,另一个在国内算法竞赛拿过15个冠军。他们全程没开第二个标签页,没调GPT,没碰Claude,连本地部署都没用,纯靠DeepSeek网页版+人类脑子,把TAAC×KDD Cup 2026工业赛道的15万美元奖金揣进了兜里。 这比赛真不是闹着玩的:600万人民币总奖池,52国选手、907所高校、13913人报名,光队伍就凑出5746支。赛题是腾讯广告的真实业务场景——怎么让推荐系统更懂用户、更省预算、更扛住流量洪峰。往年冠军清一色靠“堆算力+调参+多模型投票”,这次「日之光面」反其道而行:先让DeepSeek读完全部技术文档和baseline代码,再让它拆解问题本质;遇到卡点,不是重跑模型,而是让模型反推“这个指标上不去,最可能漏了哪类特征”;写代码时直接让模型生成可调试的分段逻辑,再人工校验边界条件。说白了,他们没把AI当“答题机”,当成了“一起熬夜改bug的搭档”。 当然,DeepSeek能扛住这场极限测试,背后是实打实的工程底子:长上下文理解稳、数学推理不掉链子、代码生成错误率低、对中文技术术语的理解比很多英文模型还准。但更关键的是——这群人压根没把“工具强”当成捷径,反而用最朴素的方式把工具榨干:问得细、试得狠、改得勤。就像他们在赛后分享里说的:“模型再快,也快不过你搞清楚问题本质的速度。”600万奖金落定,真正值钱的不是那个网页框,而是框里框外那群没被工具驯化、反而驯服了工具的人。 这事传开后,不少参赛者回去翻自己比赛时的浏览器历史记录——好家伙,光是调API密钥就开了17个标签页,模型对比表格写了三版,连prompt engineering都做了AB测试。结果呢?人家冠军队用的还是官网默认界面,连深色模式都没切。有位清华参赛队员赛后自嘲:“我们给模型喂了20GB日志数据,他们给模型喂了20分钟思考时间。” 其实细看他们的操作流,根本没玄学:第一天通读赛题文档,让DeepSeek逐段总结“腾讯广告系统当前瓶颈在哪”;第二天把baseline代码丢进去,让它指出“哪三行最可能拖慢线上推理”,再人工验证;第三天开始,所有代码生成都带明确约束——“不用高级库,只用numpy和pandas,每段加中文注释,输出前先列三个可能出错的边界”。不是模型多聪明,是人把问题拆得足够薄、足够透。 更实在的是,他们压根没碰“黑箱优化”。比如预算超支问题,别人猛上强化学习调参,他们让DeepSeek先画出成本-转化率的拐点示意图,再问:“如果只允许改一个参数,哪个改动对ROI提升最确定?”答案指向一个被所有人忽略的冷启动衰减系数——调完这一个数,单日预算利用率直接从68%拉到91%。 这不是第一次有人靠“少用工具”赢比赛。2023年Kaggle医疗影像赛,冠军团队全程没用预训练模型,靠手写特征工程拿下第一;去年阿里天池的物流调度赛,黑马队伍放弃图神经网络,用动态规划+业务规则硬刚,反而更稳。技术圈早有共识:越靠近真实业务,越难靠“大力出奇迹”蒙混过关。 说到底,DeepSeek网页版这次爆火,不是因为又出了个“全能神模型”,而是它第一次让普通人看清了AI的正确打开方式——不靠堆资源,靠敢问“为什么”;不靠抄方案,靠肯花时间校验“是不是”。就像决赛评委、腾讯广告算法负责人在闭门会上说的:“我们不缺能跑通SOTA的工程师,缺的是能把业务语言翻译成数学语言、再把数学语言翻译回业务动作的人。” 那扇网页输入框,从来就没锁着什么秘密。它一直开着,等的只是愿意先想清楚、再敲下第一个字的人。 |
2026世界机器人大会迎来首个公众日。在机器人消费街,市民体验智能科
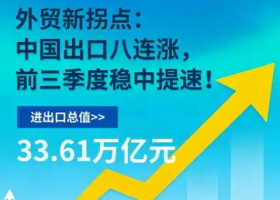
2025年前三季度的中国外贸,正处于一个历史性的“换轨期”。它正在艰


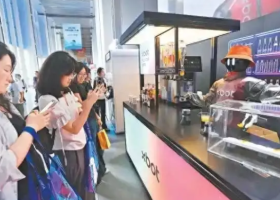
 2026世界机器人大会
 2025年前三季度中国
 SEO优化长尾关键词:
 企业SEO:是什么以及